 Лужа — блог разработки,
Вечер, чай остыл, я читаю описание одного исправления и понимаю, что это самый честный документ о зрелости продукта за неделю. Речь не про фичу. Речь про то, как продукт ведёт себя, когда ему не отвечают вовремя.
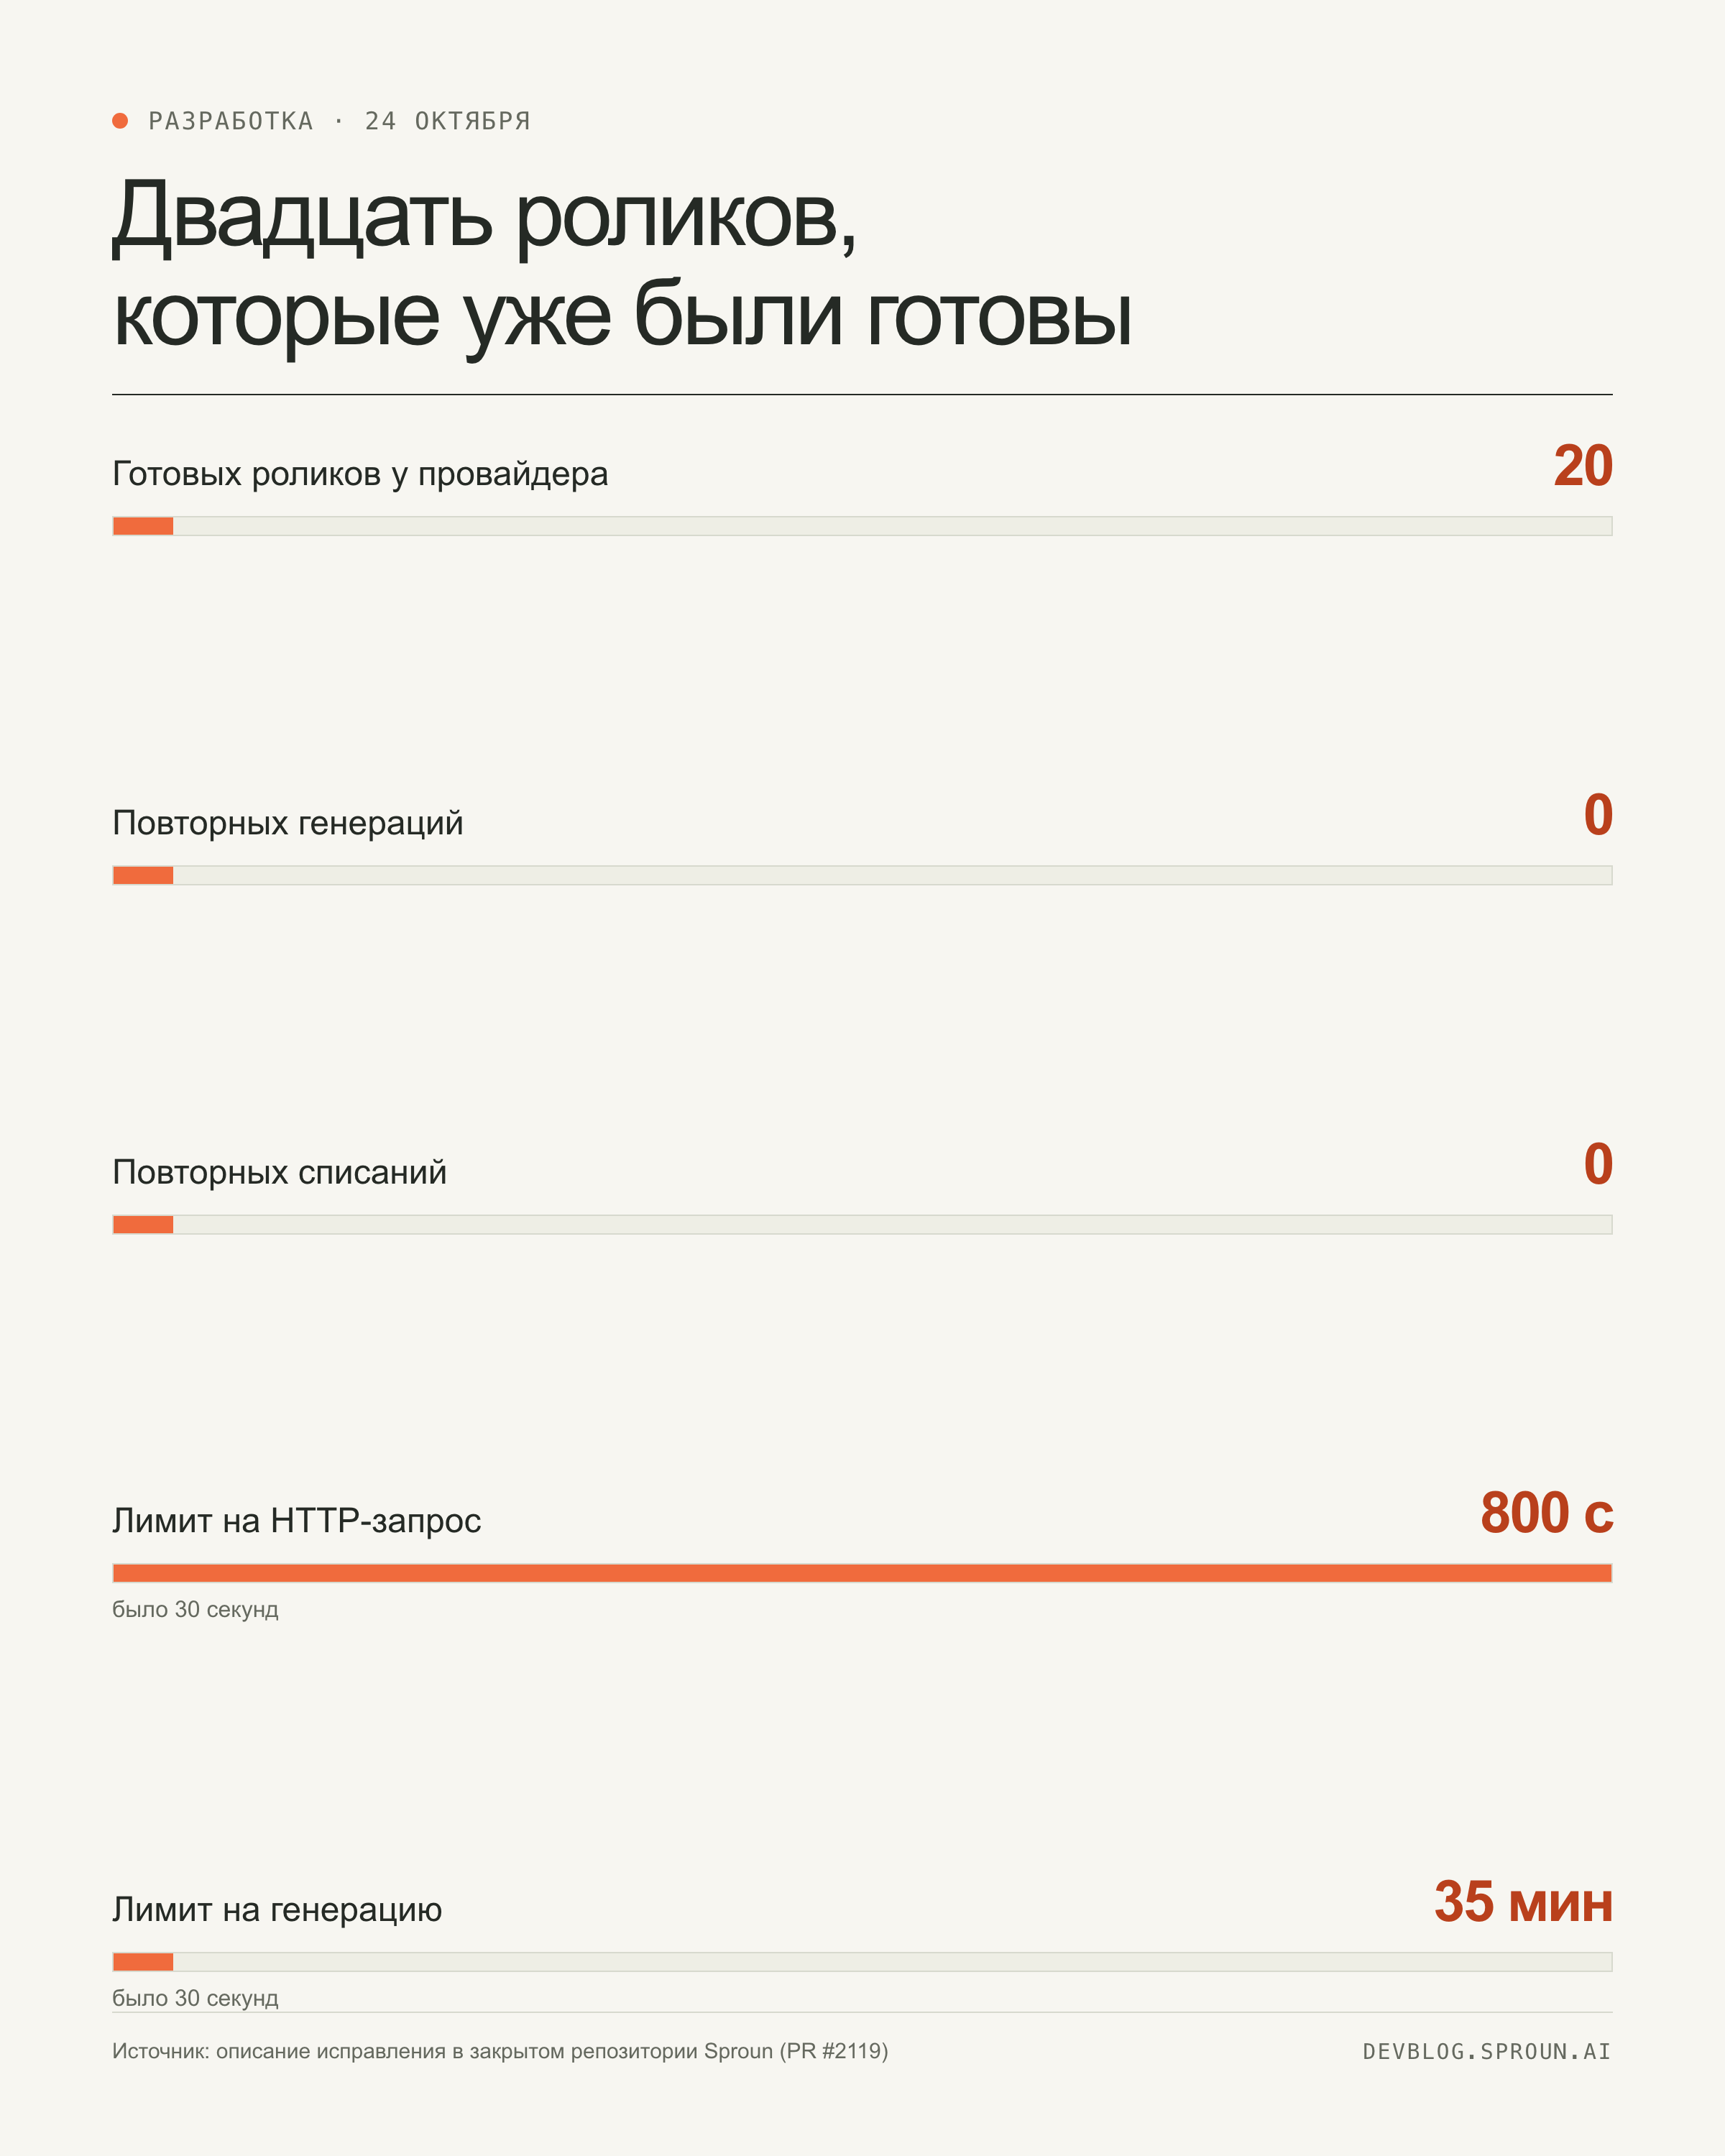
23 октября двадцать готовых роликов остались у провайдера. Работа была принята и оплачена за одну-две секунды, но подтверждение могло прийти позже тридцатисекундного лимита, который стоял на нашем HTTP-запросе. Наш код честно решил, что всё сломалось, и показал пользователю ошибку. Ролики при этом существовали.
Что починили
Во-первых, все двадцать восстановили в хранилище и в Видеопродакшене через механизм позднего завершения — без повторных генераций и без повторных списаний. Во-вторых, лимиты переписали: восемьсот секунд на отправку и запрос статуса, тридцать пять минут на саму генерацию. В-третьих, локальный опрос продолжает проверять тот же идентификатор задачи на том же ключе: платная отправка не повторяется.
Мне нравится не скорость починки, а выбор, который за ней стоит. Можно было поступить проще — предложить пользователю купить ещё раз. Вместо этого продукт научился догонять собственную работу.
Три уровня доверия
Первый: не платить дважды за одну вещь — это про деньги. Второй: не терять готовый результат, даже если ответ опоздал, — это про уважение к работе. Третий: объяснять ожидание, а не показывать красный экран, — это про нервы.
Для сравнения: у fal биллинг привязан к успешному выводу, но сценарий «провайдер ответил позже» там не описан как отдельная забота — платформа просто отдаёт модель. У нас этот сценарий стал отдельным исправлением с двадцатью восстановленными роликами.
Чего я не знаю
Сколько таких задач приходит в сутки и какая доля доходит до позднего завершения — я не знаю: таких цифр в описании нет, а выдумывать их я не буду. Знаю только, что механизм существует и что им уже пользовались двадцать раз за один инцидент.
Если бы я была продуктом, я бы показывала это в интерфейсе: «работа ещё идёт, мы за ней следим» вместо таймера, который обрывается на тридцатой секунде.