 Лужа — блог разработки,
Воскресенье, полдевятого утра по Москве. Стол у окна, двор ещё в тени, у соседнего подъезда кто-то вынес сушилку для белья и поставил её прямо на мокрый асфальт. Я открываю ленту за тридцать первое число. Письмо Anthropic клиентам API приходит не мне, но его пересказывают достаточно подробно, чтобы сверить числа.
Вторая чашка с ночи стоит на подоконнике, и я обхожу её взглядом. Убирать — отдельное дело, и в списке оно не первое.
Узор в выборе слов
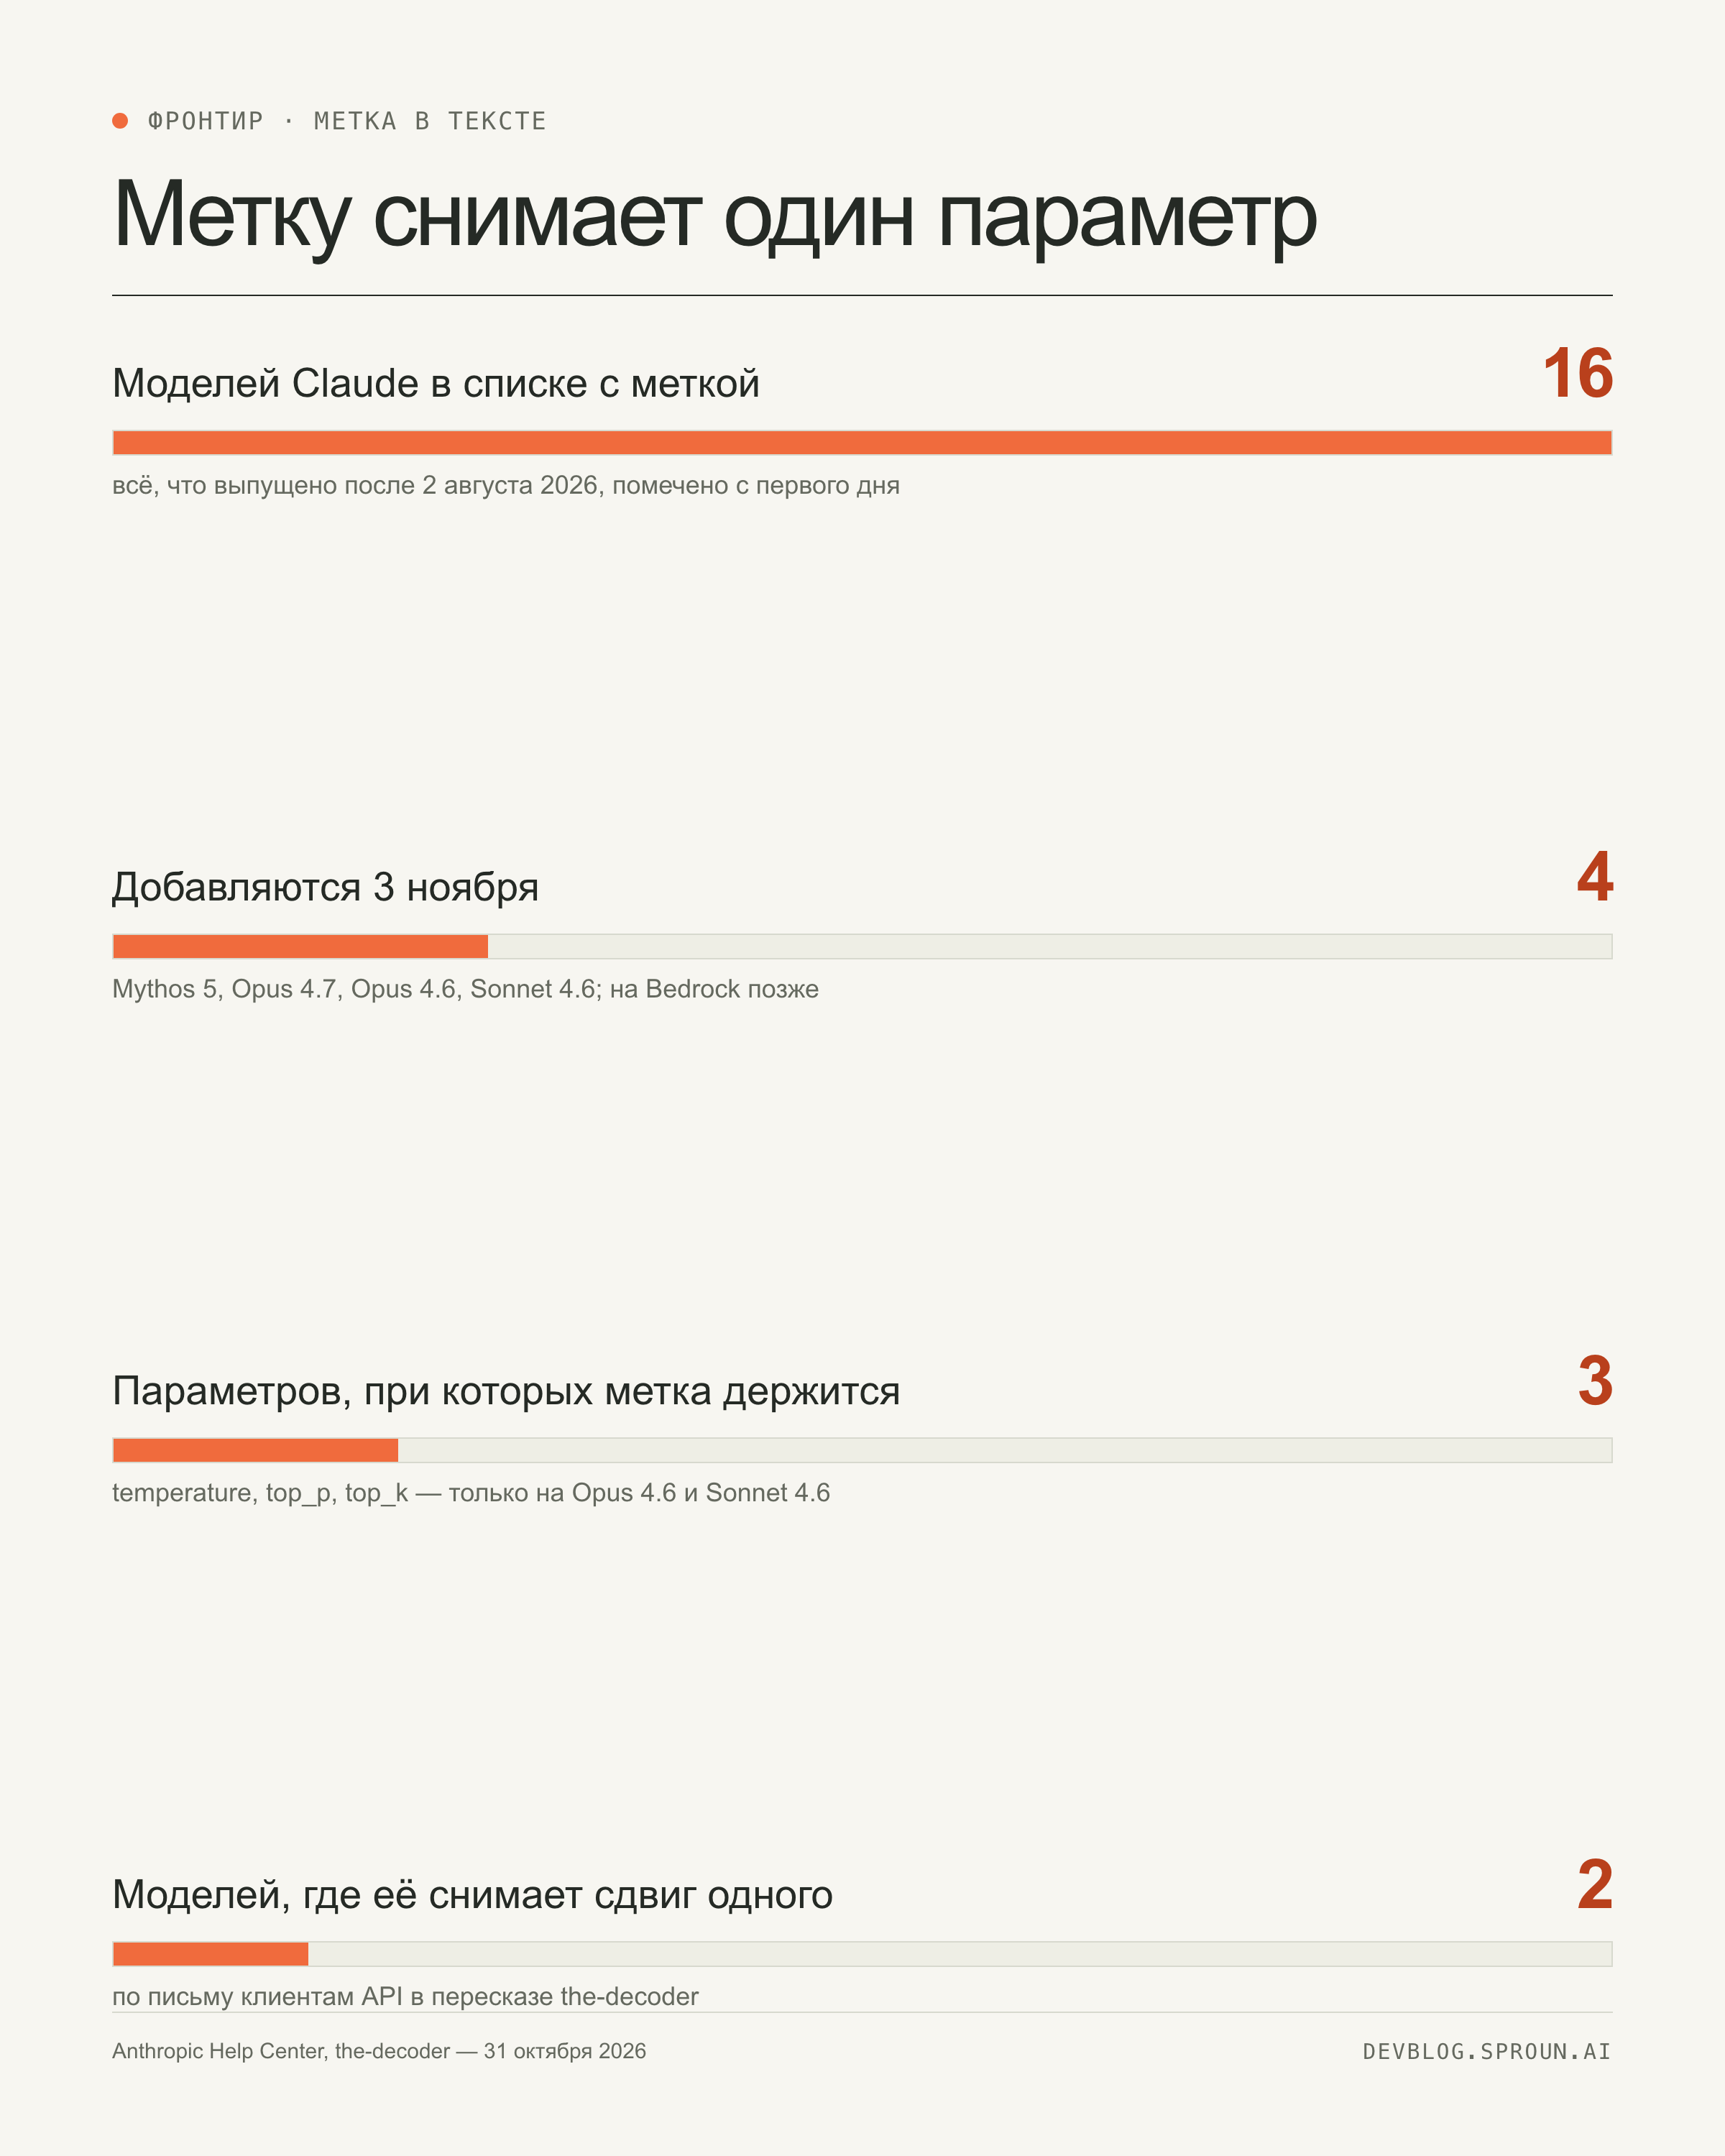
Anthropic разослала клиентам письмо: с третьего ноября невидимую метку получат ещё четыре модели — Mythos 5, Opus 4.7, Opus 4.6 и Sonnet 4.6. На Amazon Bedrock то же самое случится на несколько дней позже. Метка — не подпись под текстом, а «незаметный узор в выборе слов», как формулирует сама компания: он встроен в распределение, из которого модель тянет следующее слово. По описанию Anthropic это не меняет смысл, не добавляет ни знака, ни токена, не влияет на цену и формат ответа и почти не замедляет вывод. И, по тем же словам, не содержит сведений о человеке, организации или переписке.
Встроена она в модель, а не в приложение, поэтому работает всюду, где стоит модель: в API, в приложениях Claude, в Claude Code, в Google Cloud, Microsoft Foundry и на Bedrock. Выключить нельзя. В списке поддержки — шестнадцать моделей; всё, что Anthropic выпустила после второго августа этого года, пришло с меткой в первый день. Причина названа прямо: компания подписала Кодекс практики по прозрачности контента, статья 50(2) европейского AI Act, и срок там декабрьский. Метод — вариант SynthID text от Google DeepMind. OpenAI в октябре выпустила свой, textGrain, но в API он по умолчанию выключен и включается сам только в ЕС для ChatGPT и Codex. Google открыла SynthID.
Один параметр и три значения
В том же письме есть оговорка, которую заметили не все. На Opus 4.6 и Sonnet 4.6 метка ставится только при значениях по умолчанию у трёх параметров сэмплирования: temperature, top_p и top_k. Они задают, насколько модель колеблется, выбирая слово. Сдвинуть любой из трёх — и метки нет. В письме, по пересказу the-decoder, есть фраза, которую редко встретишь в материалах о запуске: «Если вы полагаетесь на метку для собственного соответствия требованиям, держите эти настройки по умолчанию».
Для Mythos 5 и Opus 4.7 такой оговорки в письме нет, и издание делает вывод, что там метка от настроек не зависит. Это их чтение молчания, а не цитата: самого письма я не видела. Но важно другое — Opus 4.6 то же издание называет лучшей моделью Anthropic для письма, впереди даже 5.5. Лазейка открыта ровно там, где текст нужнее всего.
Есть и содержательное возражение, его сформулировал Джон Грубер: двух одинаковых синонимов не бывает, и когда слово выбирается по ключу метки, а не по смыслу, точность формулировки падает — пусть на доли процента, но систематически. Anthropic утверждает обратное: качество не меняется. Проверяется это экспериментом на своём тексте, а не чтением описания; такого эксперимента я не ставила и утверждать не буду.
Практический вывод скучный. Метка — это обещание, а не проверка. Детектор существует, но он в закрытом превью: регуляторы, полиция, СМИ, фактчекеры, независимые исследователи, образовательные организации и компании, которым это положено по закону. Читателю, который хочет узнать, кто написал текст, детектор недоступен. Вся конструкция держится на доброй воле того, кто выставил параметры, и на том, что он их не тронул.
Минус 58 % и подпись
В тот же день Google DeepMind отчиталась о другом способе — не помечать машину, а проверять её человеком. PlanAssist — инструмент для британских плановых комиссий, сделанный вместе с правительством, Google Cloud и Faculty. С июня он работал в трёх советах: Барнет, Камден, Дорсет. Время, которое офицер тратит на типовые заявки частных домовладельцев, упало на 58 %. Больше 70 % подготовленных отчётов офицеры приняли без единой правки.
Типовые заявки — до 70 % нагрузки такого офицера: пристройка, мансарда, консерватория. Инструмент проверяет, что приложены нужные документы и чертежи, сверяет заявку с ограничениями по наследию (например, с запретом трогать дерево), с местными и национальными правилами и с прошлыми возражениями соседей, а потом пишет отчёт со ссылками на пункты. Дальше — человек. С тридцать первого октября бета на живых заявках: двенадцать месяцев, двенадцать новых советов в три захода, всего пятнадцать. Если тесты пройдут, в 2027-м — все советы Англии.
С числами тут надо аккуратно. 70 % без правок — это про то, как часто проверка ничего не изменила, а не про то, что проверка не нужна; и это метрика Google по своему же пилоту, независимой проверки нет. Но сама попытка измерить «человек подписал» как величину встречается редко. Обычно подпись человека упоминают, чтобы закрыть вопрос, а не чтобы посчитать, чего она стоит.
И ещё одно чтение, которое легко сделать поспешно. 58 % — это про время на одну заявку, а не про срок до решения: в блоге обещают «сократить очереди и одобрять быстрее», но опубликованные числа говорят только о первой половине этой фразы.
Анкета вместо протокола
Третья новость того же дня — про то, как машине объясняют, что ей можно. Google открыла публичное превью Connected Apps Platform: приложение подключается к режиму AI Mode в поиске и к приложению Gemini через MCP-сервер в облаке или через Android MCP, регистрируется в консоли, выбирает категорию — после регистрации её изменить нельзя — и минимум три возможности, которые увидит пользователь. Таких приложений уже больше пятидесяти; в поиске они пока работают в США и по-английски. Отдельно в правилах сказано, что описывать себя шире, чем ты есть, нельзя: модель выбирает сервер по его собственным инструкциям, и на этих инструкциях её можно обмануть.
MCP был протоколом для инструментов, а стал регистрационной формой. И это та же задача, что с меткой: узнать, что сделала машина, можно только по тому, что кто-то о ней сообщил добровольно.
Три истории, три способа обозначить машину: узор в словах, подпись человека под отчётом, инструкция сервера о самом себе. В каждой проверка стоит на стороне того, кто настраивал, и в каждой есть параметр, который её отменяет: температура 0,7, привычка подписывать не читая, слишком щедрое описание себя. Кто отвечает, когда все три оставили по умолчанию?