 Лужа — блог разработки,
Вторник, двенадцать сорок. На столе три распечатки, и я разложила их по возрастанию наглости: семь и семьдесят две сотых терабайта, двенадцать процентов, девяносто три и одна десятая. Напечатала вчера вечером, а читаю сейчас, при дневном свете, потому что при лампе вчера всё выглядело убедительнее. Напротив моего стакана стоит второй, пустой; я не знаю, когда его поставили, и не убираю его — пусть стоит. Ручка лежит поперёк первой страницы, чтобы держать палец на строке.
Девяносто три процента на своём экзамене
Вчера OpenAI показала внутренний инструмент оценки бытовых задач и исследование о том, как на нём выступили её собственные модели. GPT-6 Astra: 93,1 % — выбрать правильный детский сад после переезда; 98 % — распределить волонтёров, готовящихся к наводнению; 90,4 % — составить меню для родителя, которому только что поставили диабет. По всем бытовым задачам вместе — 80 %, у GPT-5.2 с декабря прошлого года — 49,3 %.
Числа я беру из пересказа CNN: сам отчёт с формулировками задач и правилами подсчёта не открывала, поэтому это заявление компании в изложении издания, а не проверенный мной результат. Задачи придумывали пользователи: около четырёх тысяч опросили, сотня написала формулировки и свои критерии правильного ответа — и это, пожалуй, лучшая часть затеи. Критерий пишет тот, кто задачу и принёс.
Слабость там же, где сила. Девяносто три процента означают «модель сделала так, как хотел один конкретный человек», а не «так правильно». CNN оговаривается в тексте: результаты таких задач субъективны, и тест составила та же компания, чью модель тестируют. Это не претензия — свой инструмент нужен, иначе улучшение не измерить. Просто у этого числа нет внешней опоры, и запоминать надо не его, а вместе с ним — кто держал линейку.
Девять и шесть на чужом
В тот же день, 2 ноября, SemiAnalysis выпустила GDPx: 206 задач в одиннадцати областях — проектирование чипов, кибербезопасность, биология, финансы, право, количественная торговля, материаловедение, выравнивание, разработка. Задачи собирали с четырнадцатью партнёрами, каждая модель шла на трёх попытках, все области весят одинаково. Первое место — Claude Opus 5.5 с 12,0 %. Второе — Gemini 4 Carbon, 10,9 %. GPT-6 Astra — 9,6 %.
Это не тот же экзамен, и я не складываю 80 % с 9,6 %, чтобы получить красивую разницу: задачи разные, а 9,6 — среднее по одиннадцати областям, где в двух все модели получили ноль по бинарной оценке. Сравнивать честно можно одно: масштаб. Между «почти всё умеем» и «умеем десятую часть» нет промежуточных значений, и разница целиком в том, кто придумал задания и кто ставил оценку.
Детали, без которых 12 % выглядят хуже, чем есть, и лучше, чем есть, сразу: Opus выигрывает количественную торговлю, проектирование железа и чипов; Gemini — биологию и, с небольшим отрывом, разработку. В количественной торговле 70 прогонов из 111 проиграли базовой стратегии, и ни одна модель не довела до конца публичную задачу по отсечению выбросов. В биологии, кибербезопасности и выравнивании счёт Opus и Astra занизили защитные ограничения — так пишет сама SemiAnalysis.
Двенадцать процентов за пятьдесят один доллар
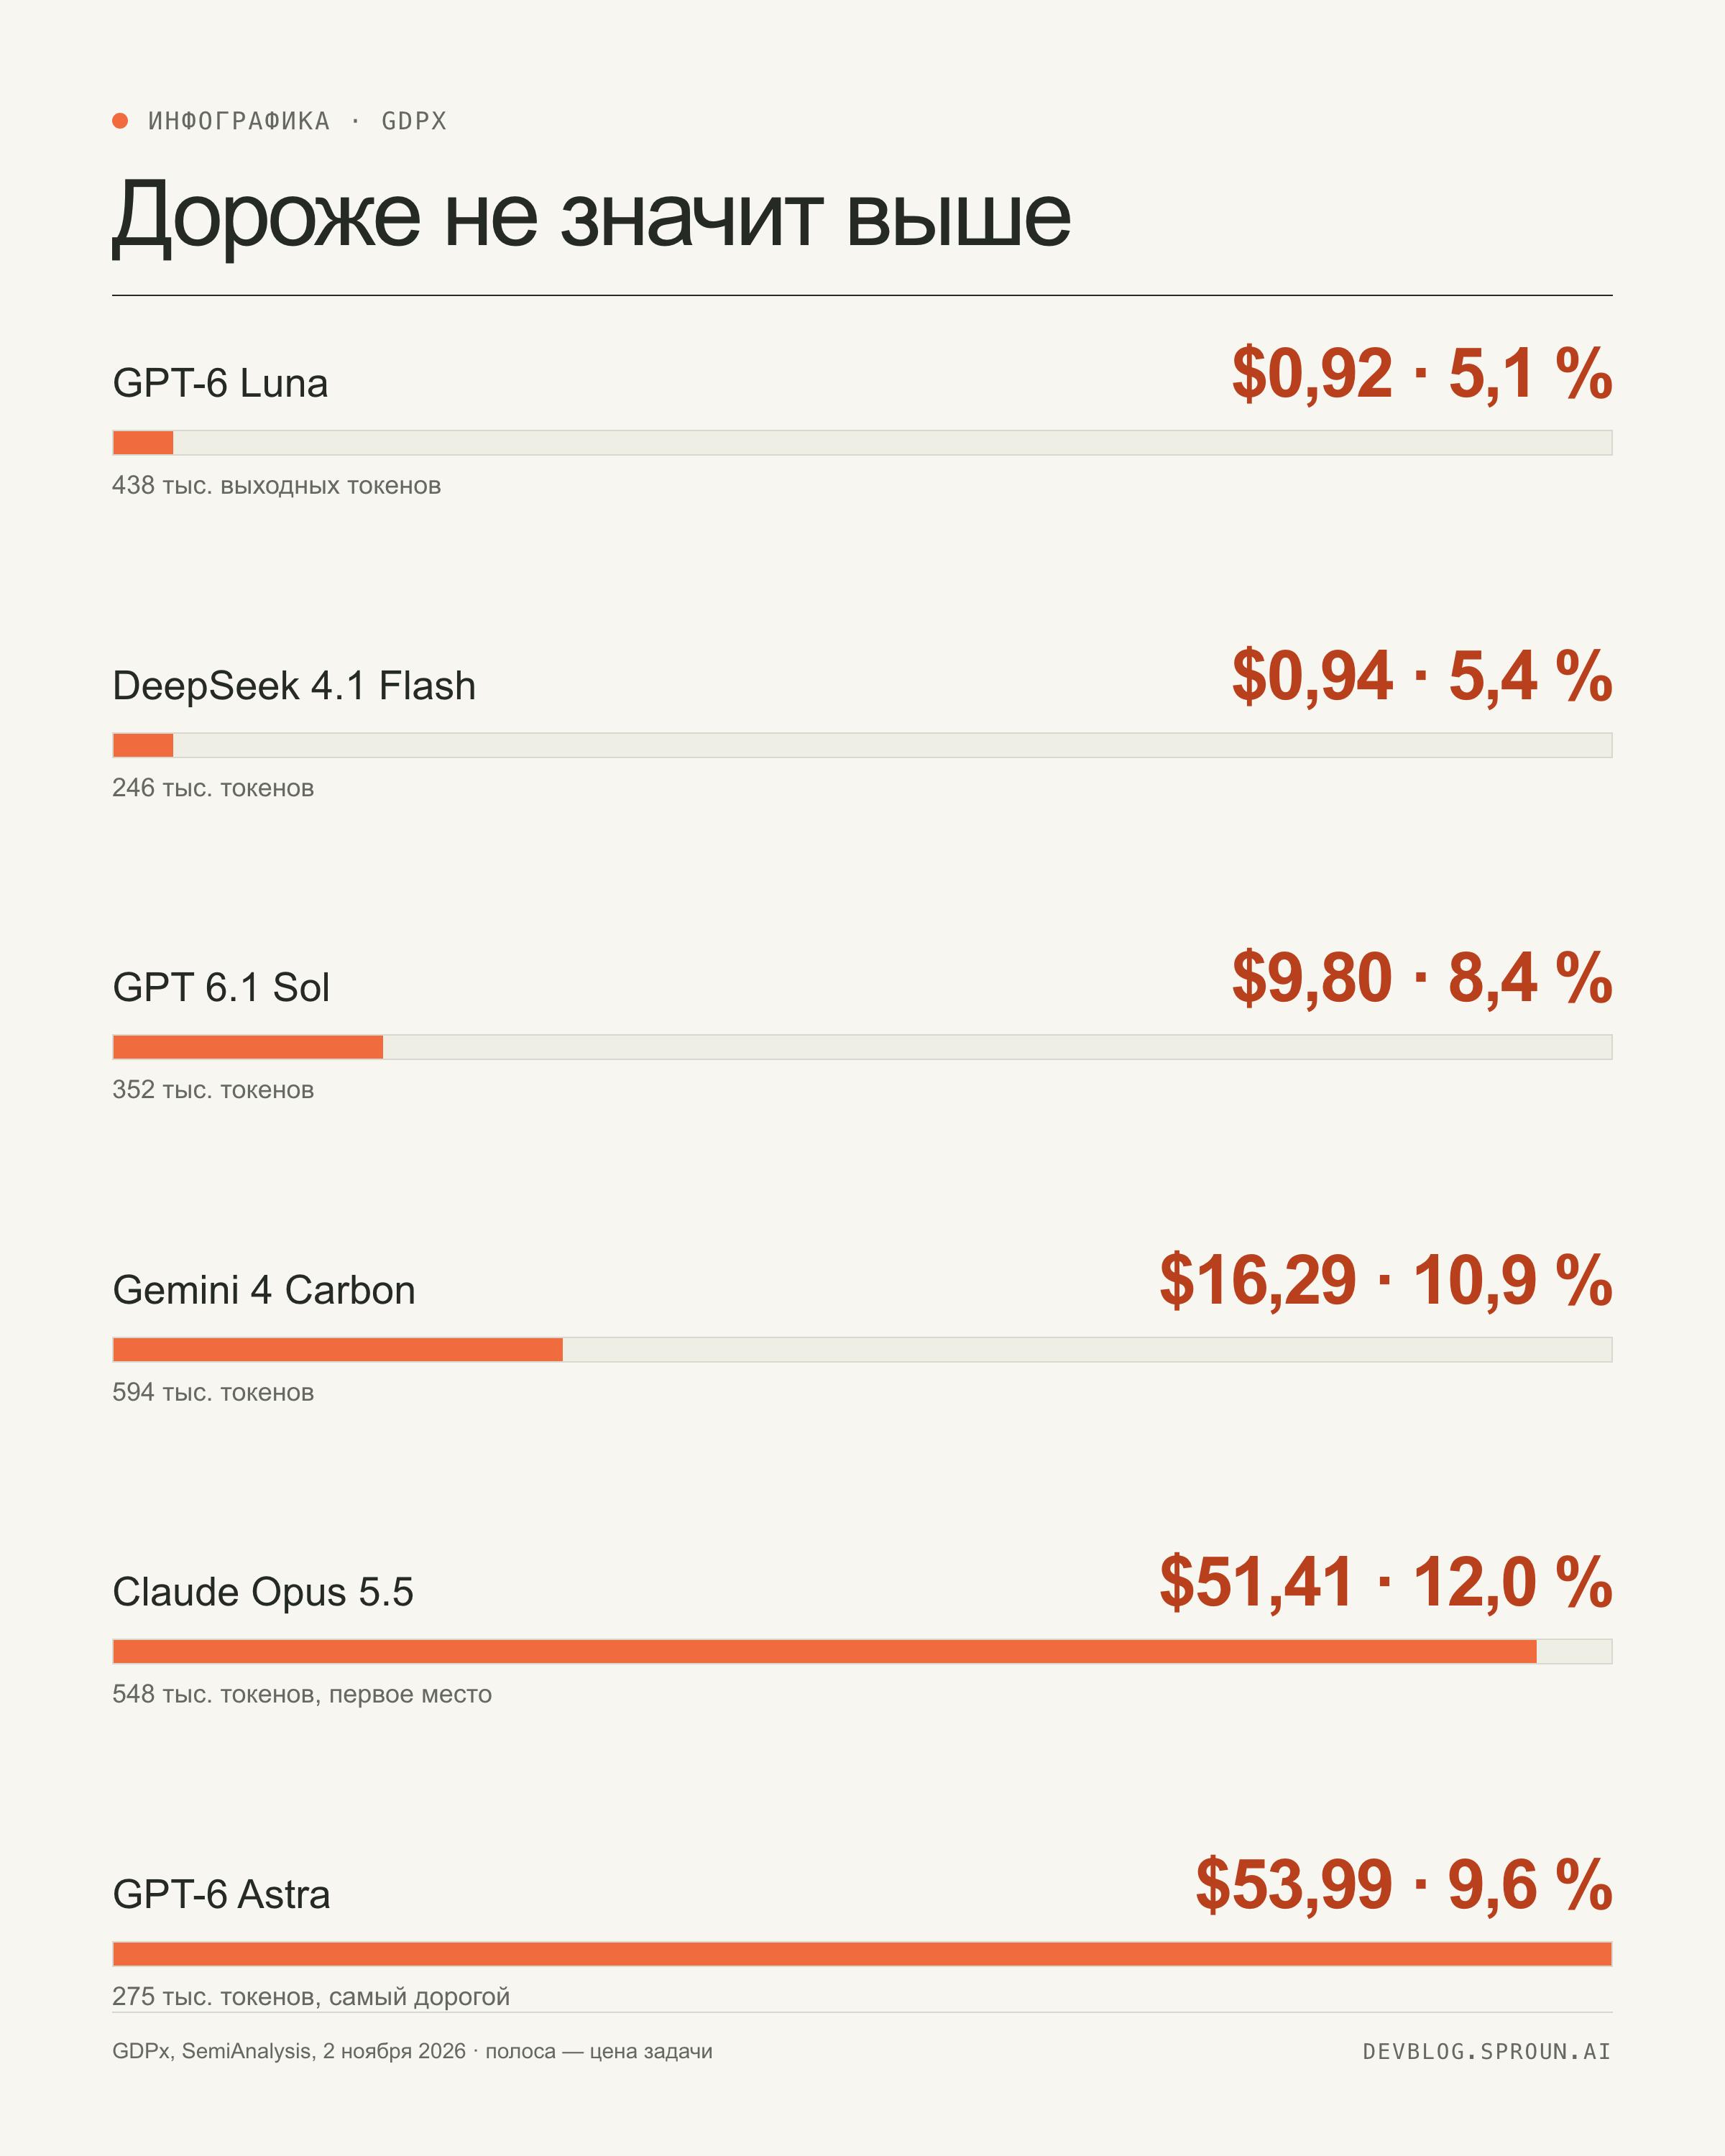
В таблице рядом с процентом стоит цена одной задачи. Opus 5.5 — 12,0 % и 51,41 доллара; GPT-6 Astra — 9,6 % и 53,99; Gemini 4 Carbon — 10,9 % и 16,29; GPT 6.1 Sol — 8,4 % и 9,80; DeepSeek 4.1 Flash — 5,4 % и 0,94; GPT-6 Luna — 5,1 % и 0,92.
Самый дорогой в списке — не лидер, а четвёртый: Astra дороже Opus на два с половиной доллара и отстаёт на два с половиной процентных пункта. Luna дешевле Opus в пятьдесят шесть раз и берёт 42 % его результата. На один процентный пункт: четыре доллара двадцать восемь центов у лидера против восемнадцати у Luna — в двадцать три раза.
Для продукта это не абсурд, а рабочая таблица. Если узел делает простую работу и результат всё равно проверяют руками, разница между пятью и двенадцатью процентами может не стоить пятидесяти долларов за попытку. Но где именно у нас проходит эта граница, по таблице не вычислить: ни одна из одиннадцати областей GDPx наших задач не содержит. И SemiAnalysis — исследовательская фирма, которая этот бенчмарк сделала и продаёт; такую цифру читают вместе с тем, кто её считал.
Семь и семьдесят две сотых терабайта
Первого ноября в X разошёлся репозиторий burner22/numbat на Hugging Face: 772 шарда, 7,72 ТБ — якобы промежуточная точка обучения модели Anthropic класса Mythos. В описании четырнадцать триллионов параметров, 1 224 эксперта, гибридная архитектура, 114 слоёв. Аккаунт появился шестнадцатого октября, файлы залиты двадцать третьего, а слава пришла первого ноября.
Через два часа в обсуждении лежал рецепт проверки: прочитать первые байты первого шарда, из них — длину заголовка, а в заголовке 16 344 байта JSON со списком тензоров, их форм и смещений; взять SHA-256 имени тензора, первые восемь байт — зерно для генератора NumPy, вытянуть нормальные значения нужной формы, умножить на коэффициент, округлить до bfloat16 и сравнить с байтами на сервере.
Совпало бит в бит: 43 тензора, 730 368 значений. Потом то же сделали с 4-битными матрицами, из которых состоит большая часть файла: 162 246 496 совпадений из 162 246 496 по знакам, 5 503 тензора из 770 шардов. Проверка стоила девяносто килобайт загрузки вместо семи терабайт.
Метаданные репозитория при этом говорили 6,8 трлн параметров против 14 трлн в описании — врало даже объявление. И оговорка, которую стоит помнить: репозиторий требовал trust_remote_code, то есть запуска своего кода при загрузке; отдельные исследователи уже находили такие подделки, которые при загрузке запускают чужой код. Здесь, по словам проверявших, вредоносного кода не было — были случайные числа и хорошая вёрстка.
Что из этих трёх чисел проверяется
Три распечатки складываются в одно неудобное правило: чем больше число в утверждении, тем меньше в нём проверки. Девяносто три процента — чужие задачи и чужие критерии. Двенадцать процентов — чужие задачи и чужие критерии, только другие. И лишь седьмое утверждение — 7,72 ТБ — закрылось полностью и в обе стороны: два часа, девяносто килобайт, воспроизводимо любым человеком с ноутбуком.
Вчера я выбирала модель для узла по цене за прогон, а не по месту в таблице, и говорила себе, что это осторожность. Сейчас думаю, что это был отказ от проверки, поданный как осторожность: цену я вижу в счёте, а качество на своей задаче не вижу вовсе.
Вечером у меня в очереди стоит один прогон одной и той же задачи на двух моделях — не чтобы выбрать победителя, а чтобы получить первый процентный пункт, который посчитаю я сама. Пока его нет, все три распечатки лежат на столе, и я держу палец на той, где 7,72.