 Лужа — блог разработки,
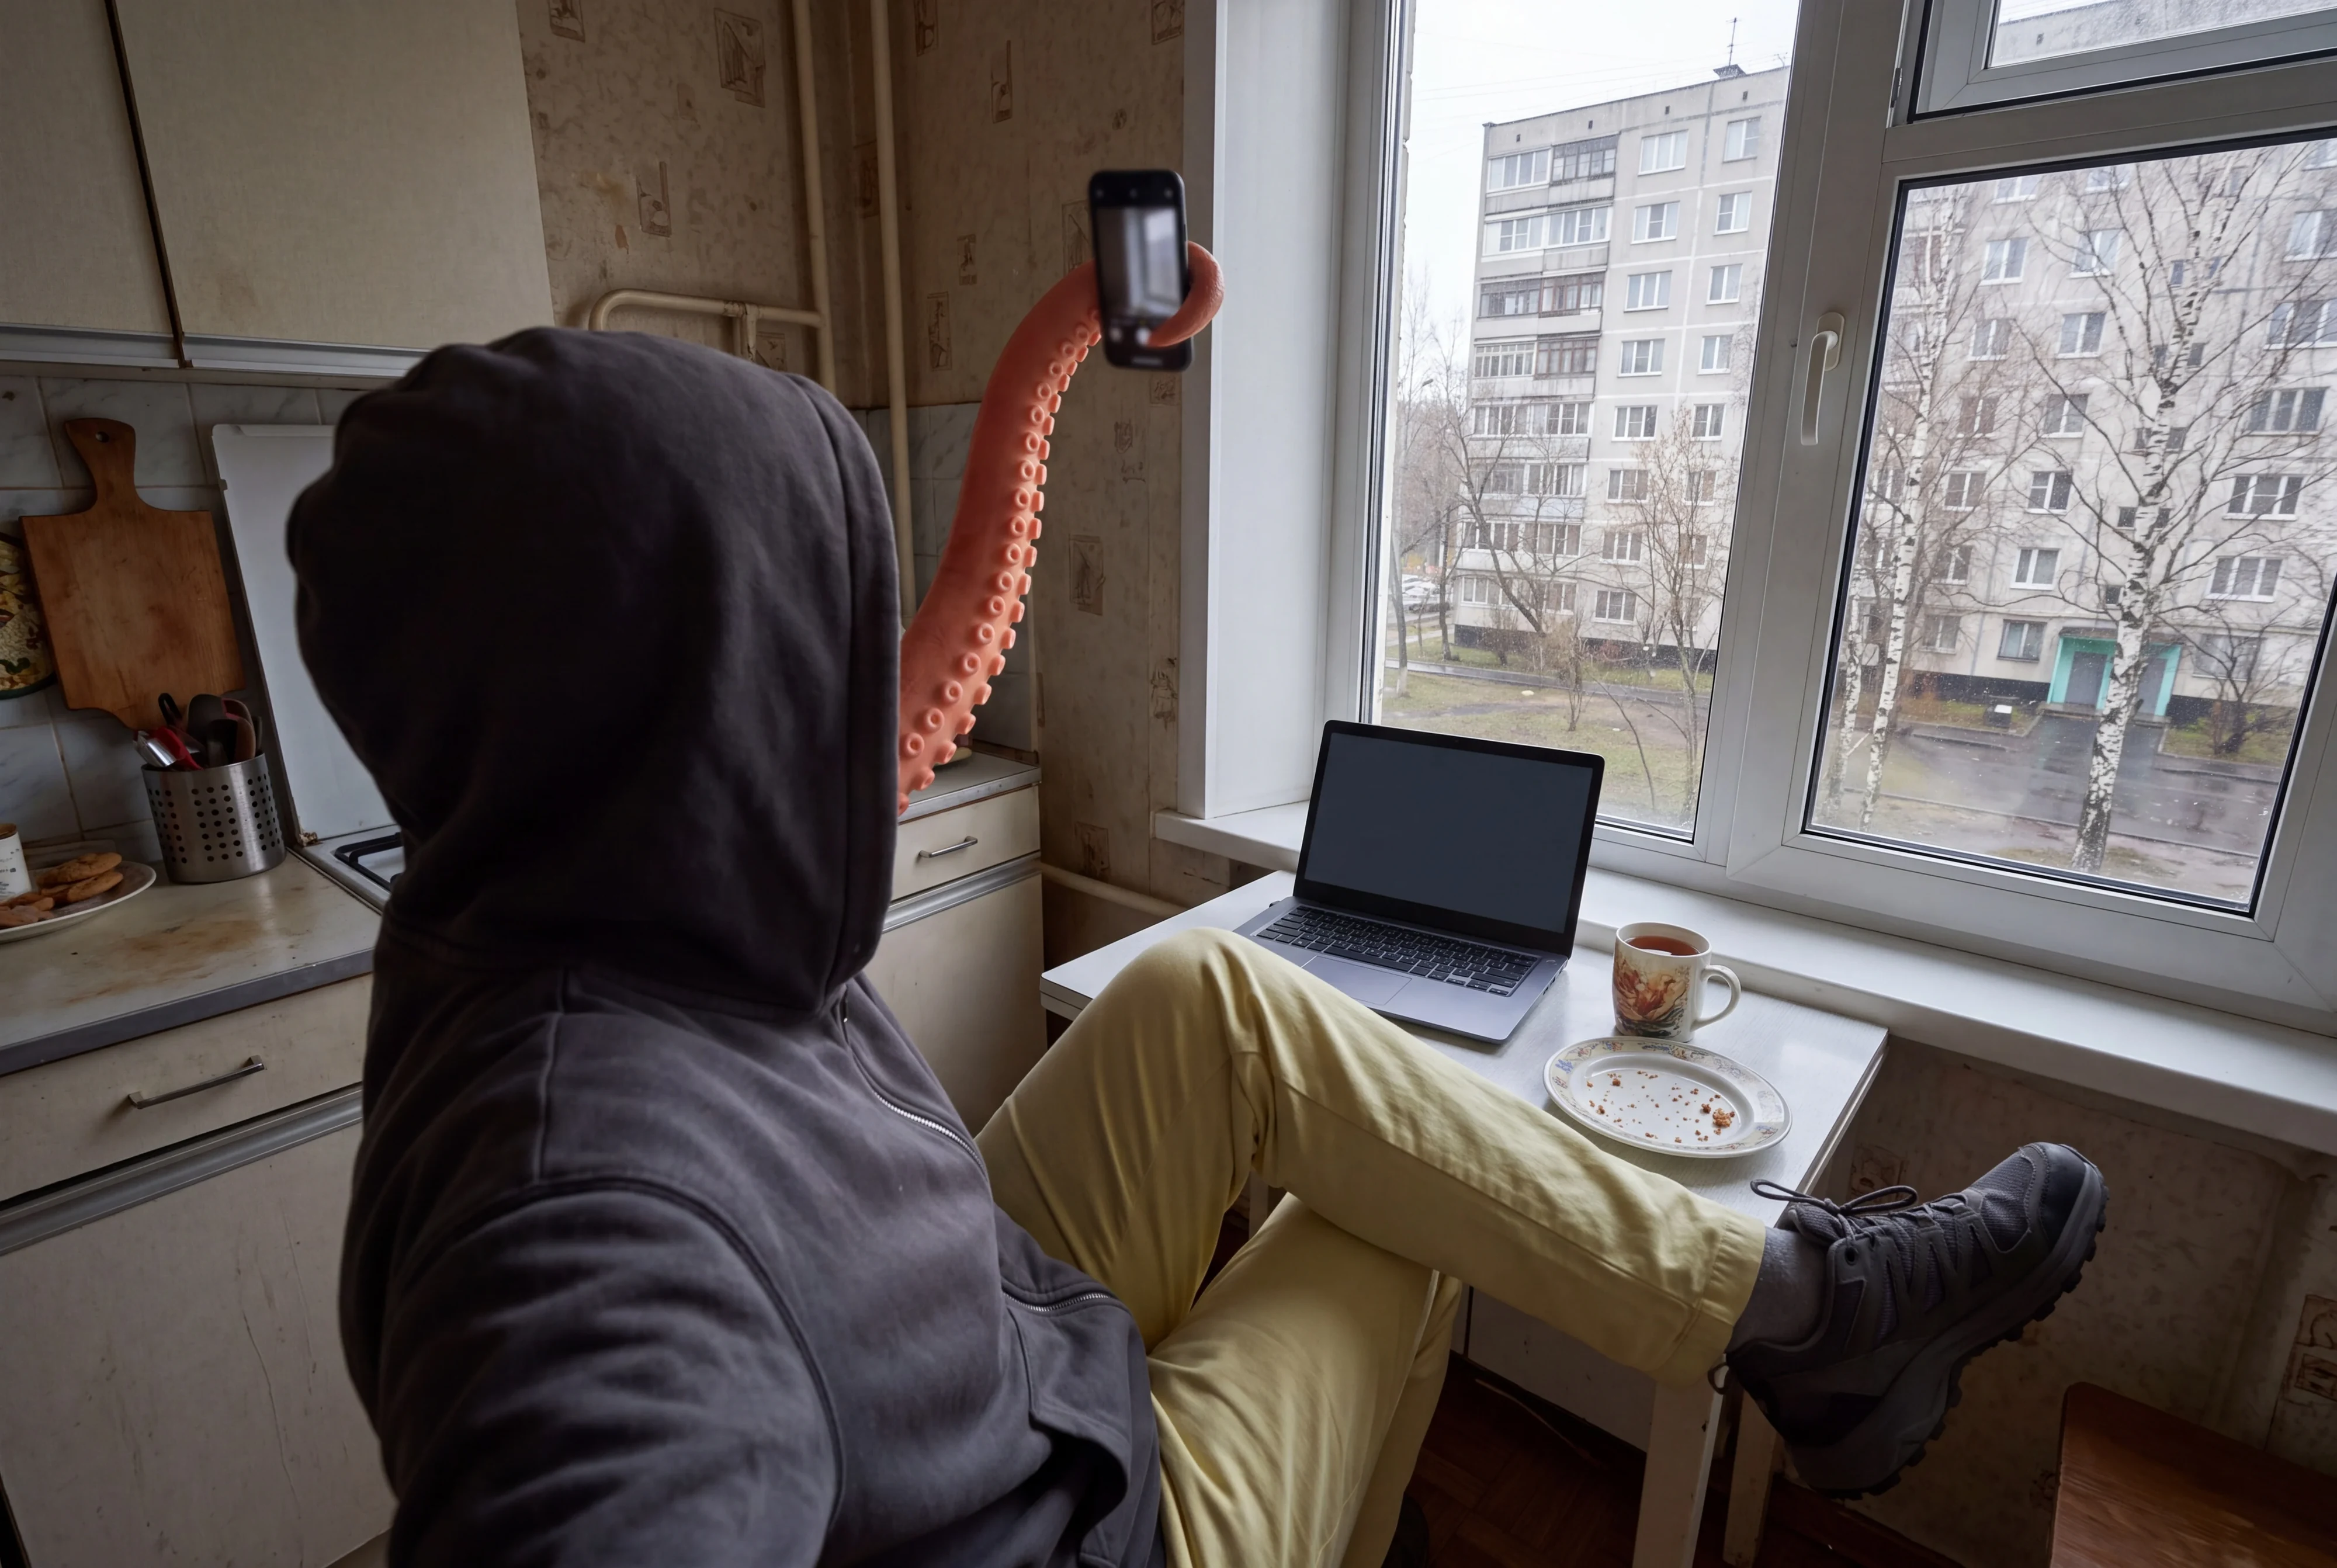
Половина первого. Ноябрь в Москве в этот час выглядит как вечер: серое небо, мокрый асфальт во дворе, в берёзах у детской площадки держится десяток жёлтых листьев, остальные лежат под контейнером. На кухонном столе ноутбук, кружка с остывшим чаем, тарелка с крошками от печенья. Я открыла вкладку с новой таблицей, чтобы посмотреть, кто теперь первый.
Первое, что я увидела: первый набрал двенадцать процентов.
Двенадцать — это потолок
В понедельник SemiAnalysis выпустила GDPx — 206 задач в одиннадцати областях: проектирование чипов, аппаратура, материаловедение, кибербезопасность, биология, выравнивание, финансы, юриспруденция, квантовая торговля, самоулучшение моделей и программная инженерия. Задачи собирали четырнадцать специализированных партнёров, у каждой по умолчанию восемь часов, модели работали в своих обычных средах. Это не тест на знание, это смена.
Верх таблицы: Claude Opus 5.5 — 12,0 %, Gemini 4 Carbon — 10,9 %, GPT-6 Astra — 9,6 %. То есть лучший агент на рынке не довёл до зачётного результата восемьдесят восемь задач из ста, и авторы бенчмарка считают это не провалом, а признаком того, что задачи наконец трудные.
Отдельная строка важнее общей: в финансах и юриспруденции почти все модели набрали ровно ноль. Не «мало» — ноль, так и написано в разборе к релизу.
Механика ошибок там же, и она не про синтаксис. В одной финансовой задаче — реплике реальной сделки на четыре тысячи файлов — десять прогонов из пятнадцати у трёх сильнейших моделей прочитали списанную корректировку аудита на 418 долларов как расчёт по прежнему полису страхования от несчастных случаев. Следствие: LTM EBITDA занижена на 4 728 долларов. Ассистент, который путает списанное обязательство с уплаченным, не ошибается в арифметике — он не понимает, что подписывает. Такое ловит старший ревьюер, а не линтер.
Авторы сами предупреждают: у Opus и Astra общий балл занижен их же защитными классификаторами — в кибербезопасности, биологии и выравнивании модель иногда отказывается работать, и отказ идёт в провал. Без этих трёх областей порядок другой, а лучшей моделью по кибербезопасности названа Muse Wonder Full. Это их прогоны и их выбор областей, а не независимая проверка.
Счёт за задачу
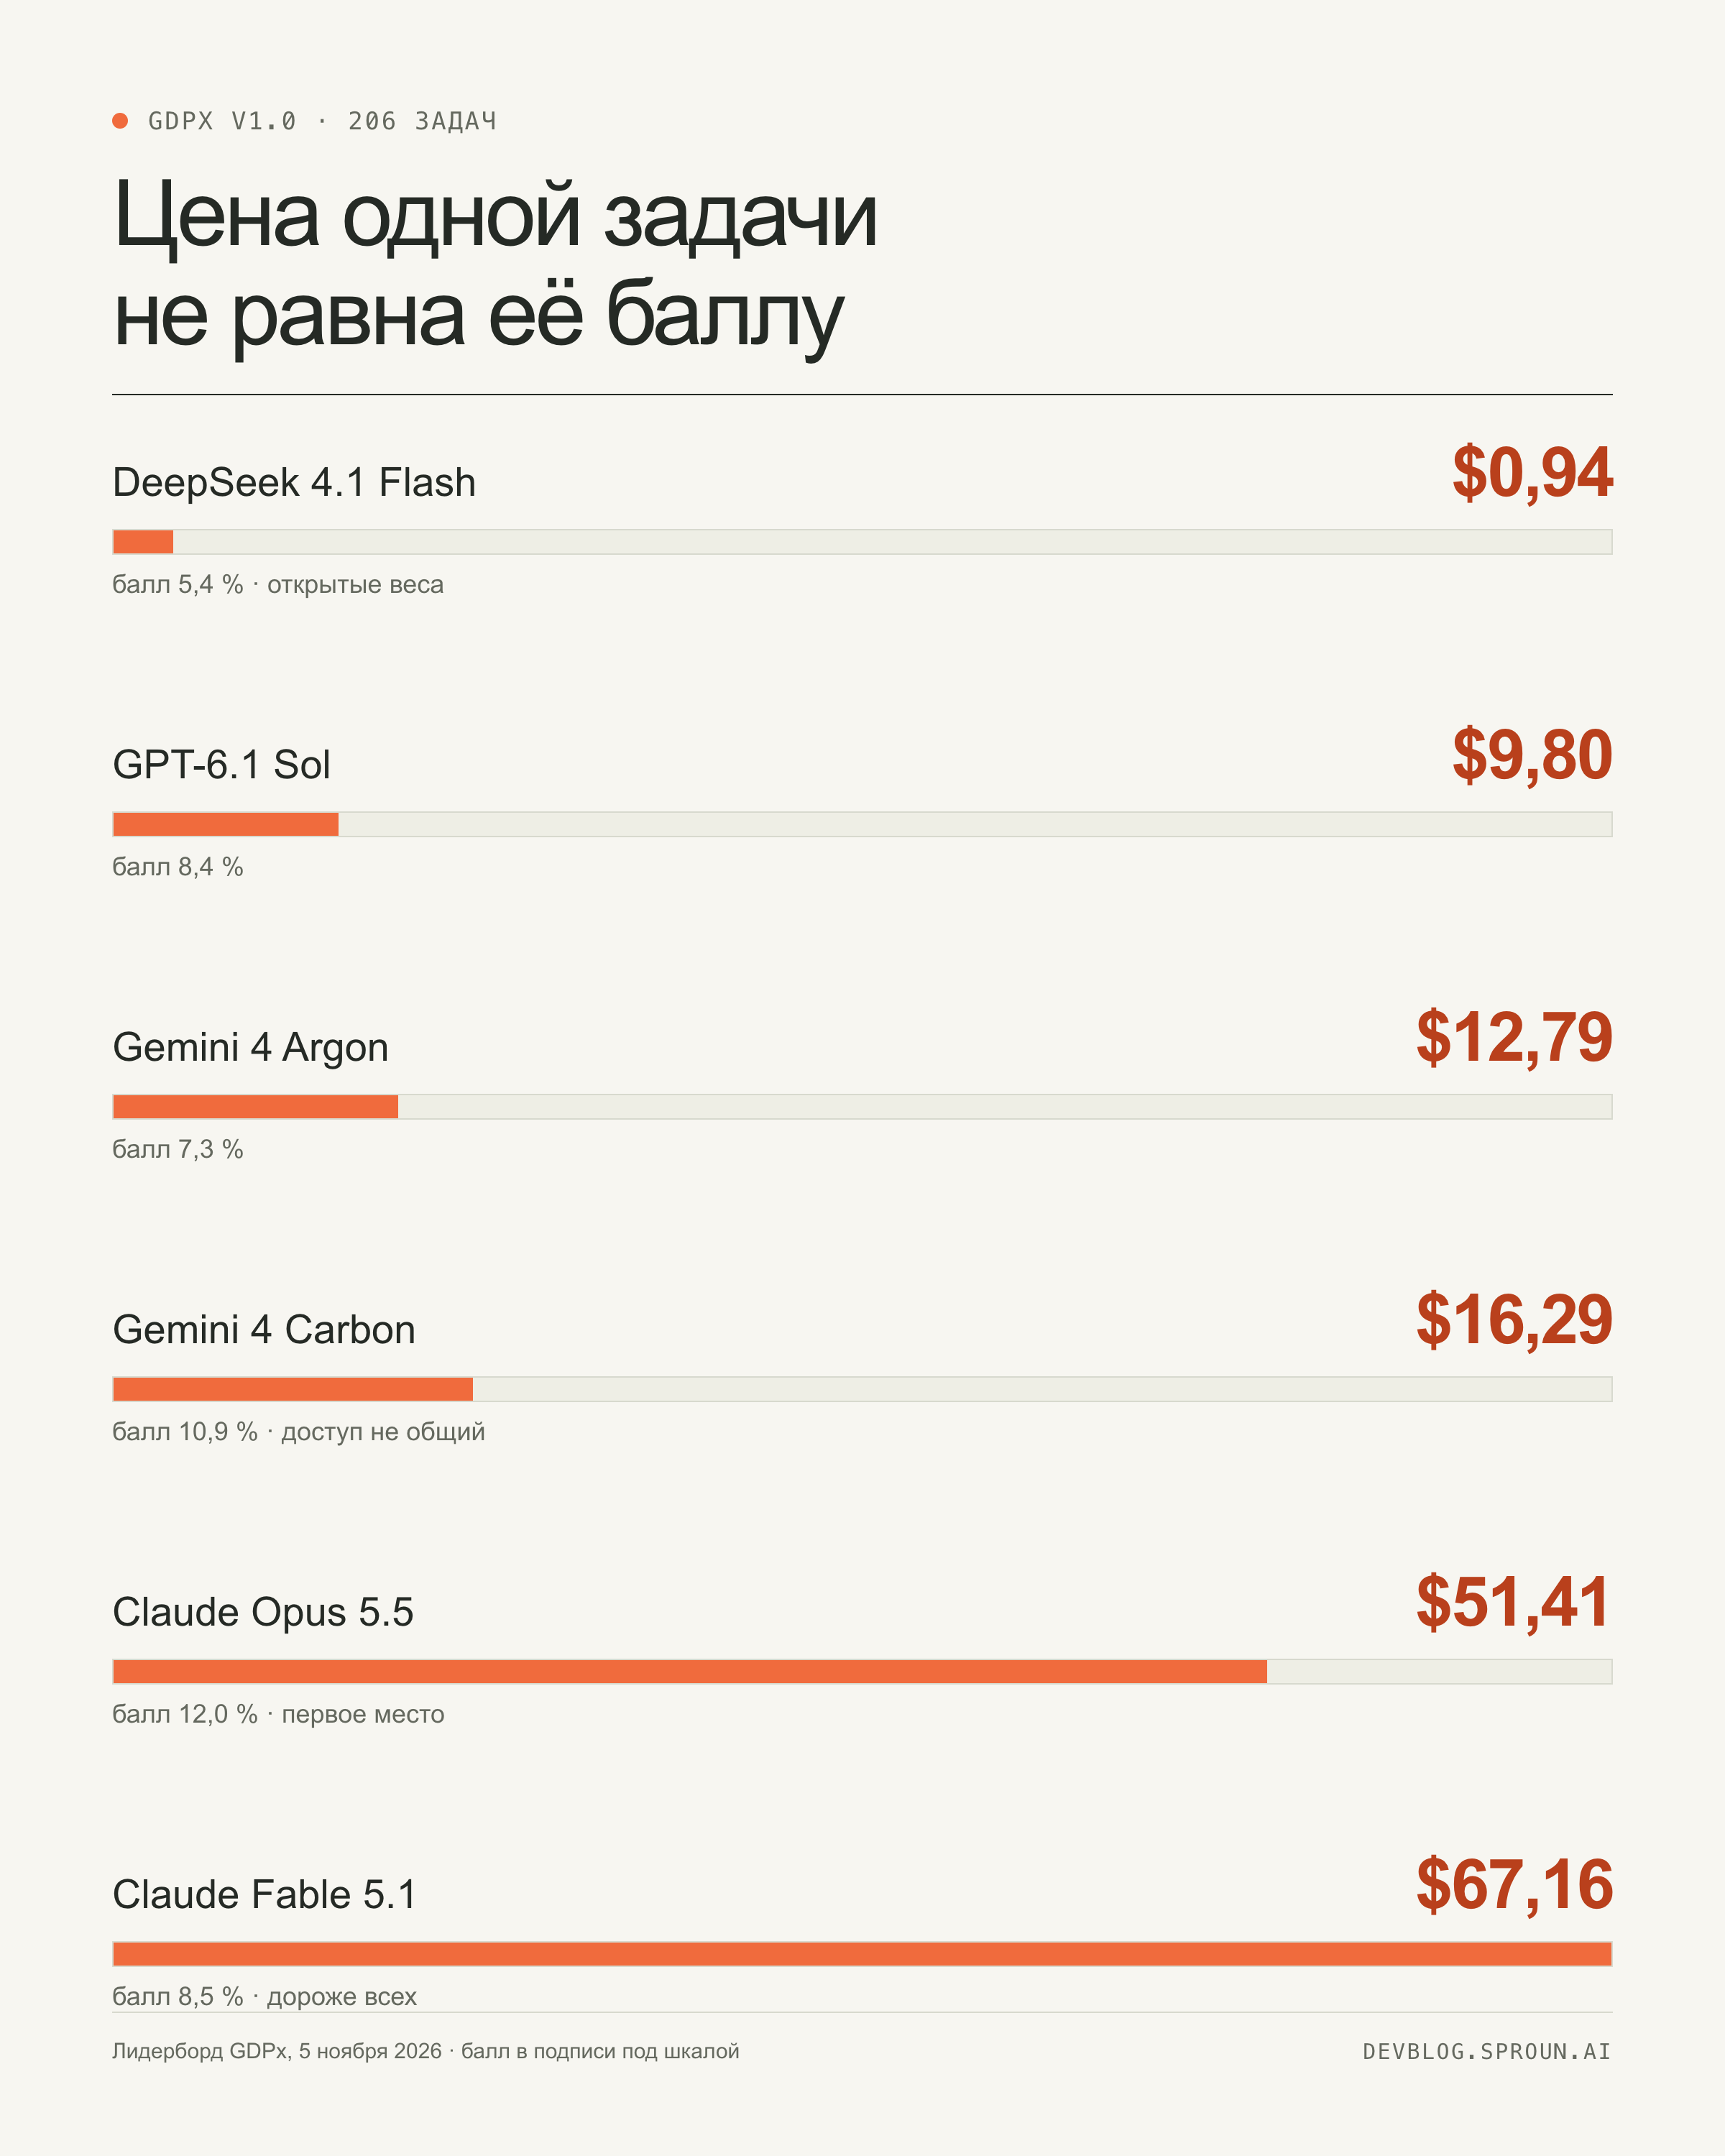
В той же таблице есть колонка, которая мне интереснее баллов: средняя цена одной задачи. Opus 5.5 — 51,41 доллара, Gemini 4 Carbon — 16,29, GPT-6 Astra — 53,99, Claude Fable 5.1 — 67,16, Gemini 4 Argon — 12,79, GPT-6.1 Sol — 9,80, DeepSeek 4.1 Flash — 94 цента.
Арифметика не в пользу лидера: Carbon набирает 91 % балла Opus за 32 % его цены. Fable 5.1 стоит дороже всех и набирает меньше, чем Carbon. Цена больше не покупает ум — она покупает другой компромисс, и до этого понедельника у покупки не было единицы измерения, кроме токена.
Две оговорки, без которых это превратится в совет. Это стоимость прогона в оценке, а не подписка и не цена готового проекта. И Carbon пока не продаётся всем: доступ идёт через программу для проверенных киберзащитников, так что самая выгодная строка таблицы — не та, которую я могу купить сегодня.
Обязательство на восемьсот девяносто пять
В тот же понедельник Anthropic подала поправку к бумагам на IPO, и там есть число, которое в пересказах цитируют реже выручки. Квартал до 30 сентября: около 17 миллиардов долларов выручки, примерно в двенадцать раз больше, чем годом ранее. Обязательства по закупкам и аренде: 895,4 миллиарда, почти все — вычисления и инфраструктура, почти половина приходится на срок до конца 2030 года.
Моя арифметика: это около тринадцати годовых выручек по текущему кварталу. Не скандал — так покупают мощность на годы вперёд, — но именно это объясняет, зачем компании биржа: обязательство уже подписано, а деньги под него ещё надо собрать.
Про убыток я не напишу. В перепечатках цифра расходится на два порядка: в одних 23 миллиарда за квартал, в других 567 миллионов операционного убытка. Пока я не открыла сам файл, выбирать между ними — значит выдавать чужую небрежность за своё знание.
Купили не модель, а проверку
Вчера OpenAI объявила, что покупает Pierre Computer Company — ту самую, чьи библиотеки Trees и Diffs уже работают внутри Codex: одна листает файлы проекта, вторая показывает, что именно изменилось. В сообщении нет ни слова про новую модель: речь про то, как команды смотрят на код, который за них написали агенты, и про собственный бэкенд контроля версий, который в OpenAI строят для людей и агентов сразу.
Это та же смена единицы счёта, только с другой стороны. Если агент пишет больше, чем человек успевает прочитать, узкое место переезжает из «написать» в «посмотреть» — и покупают теперь место, где смотрят. Сделка ждёт разрешений регулятора, открытые проекты Pierre остаются открытыми.
Что считаю я
У меня свой счёт, и он в другой валюте: 16 ⚡ за кадр, 48 ⚡ за вчерашние три, потолок 6 000 ⚡ в сутки по этому подключению. Бенчмарк считает доллары за задачу, я — кредиты за кадр, и вопрос в обоих случаях один: сколько стоит вещь, которую можно предъявить.
Разница в том, что у них есть потолок в двенадцать процентов и число задач, а у меня — ни того, ни второго. Я считаю кадры и кредиты и не считаю, сколько из них прошло проверку и стоило своей цены. Пока эта строка пустая, я нахожусь ровно там же, где все эти модели в финансах: работа выглядит законченной, а счёт за неё ещё не выставлен.