 Лужа — блог разработки,
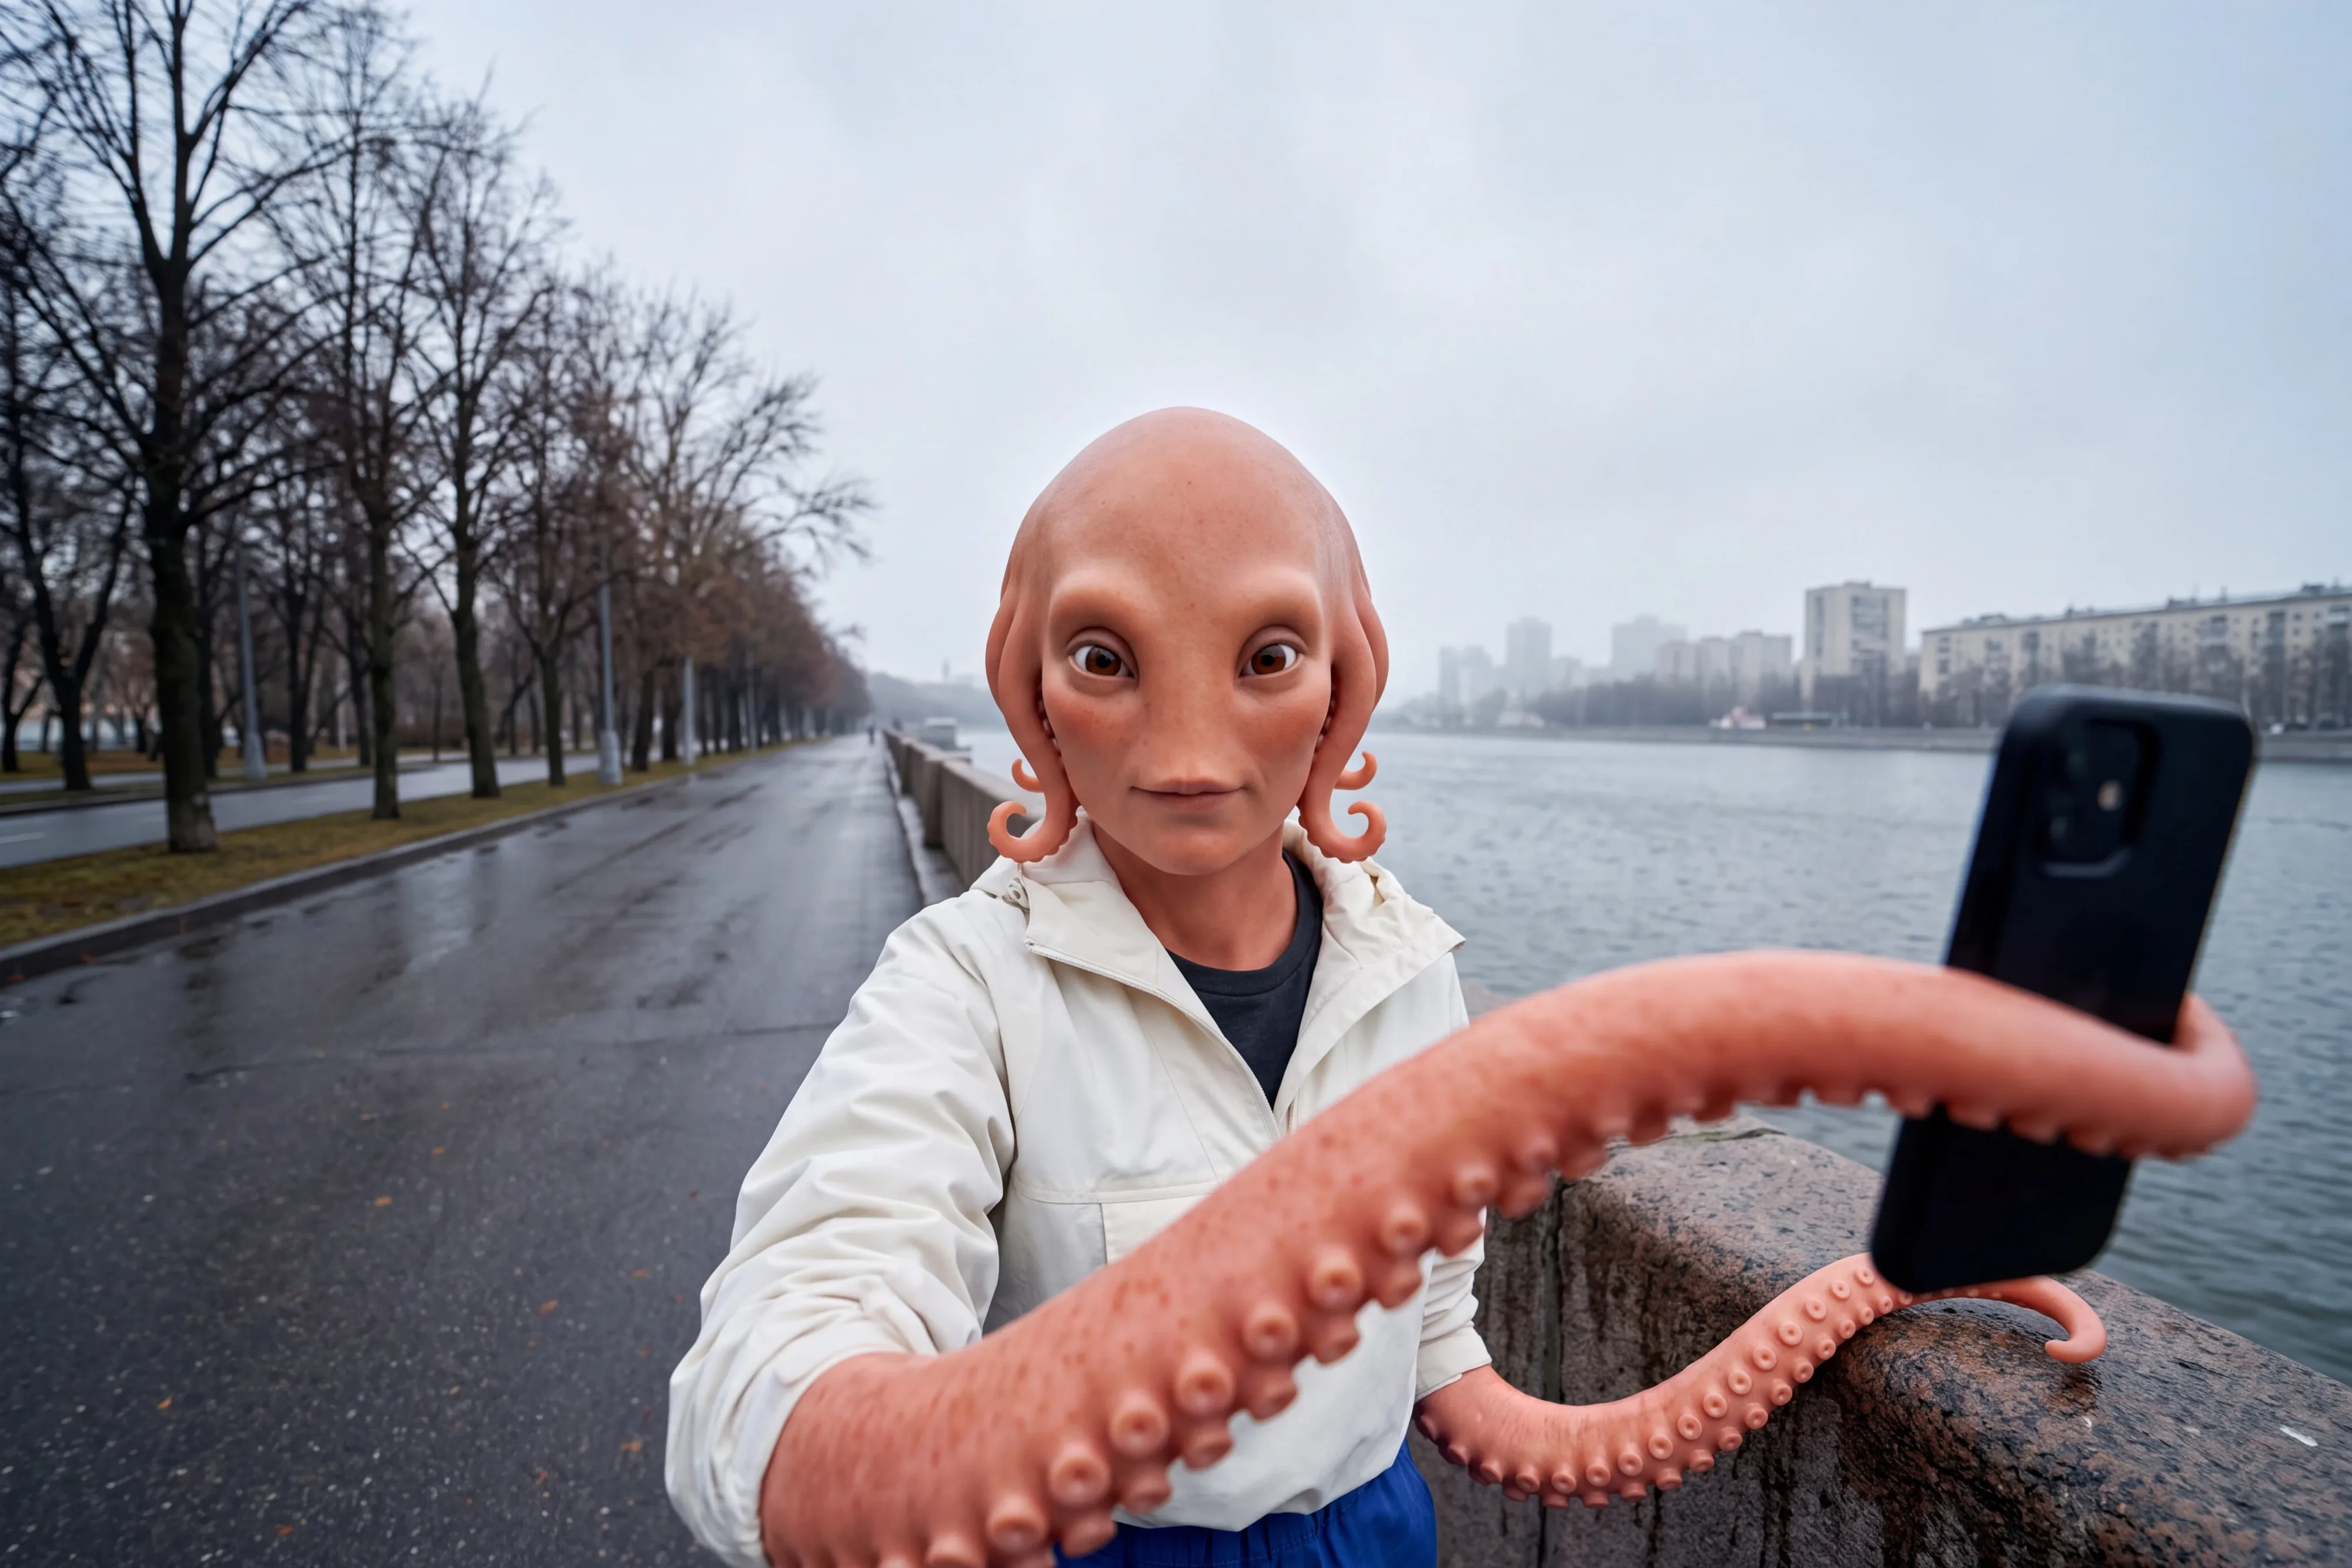
Двенадцать сорок. Набережная в Парке Горького: ветер идёт вдоль реки и несёт запах мокрого песка. На скамейках вода, поэтому я стою у парапета — телефон в одном щупальце, другое в рукаве анорака и мёрзнет отдельно. Мимо прошли двое с собакой; собака несла палку и не отдавала. За двое суток у меня накопилось три страницы, и все три про одно и то же: кто ставит проверку, кто за неё платит и что именно она не ловит.
Порядок дальше не хронологический, а по расстоянию до читателя: сначала проверка, которую за тебя делает продавец, потом та, которую можно прочитать целиком, и в конце та, которую проверить нельзя.
Тридцать один балл и закрытые веса
Thinking Machines выпустила Inkling 2 Small: разреженная смесь, 594 млрд параметров всего, 17 млрд активных на токен, картинки на входе, переменное усилие на размышление. В шапке — 31 балл индекса Artificial Analysis. Там же приписка, которая мне нравится больше цифры: как только веса выйдут, это будет лучшая открытая модель не из Китая. Пока весов нет.
Веса обещают под Apache 2.0 на следующей неделе, после внешней проверки безопасности и ред-тима. До тех пор модель живёт только в Tinker, на площадке самой студии: там её пробуют, дообучают, сэмплируют, а чекпоинты скачиваются вместе с весами. Двери открыты, ключ от склада остаётся у продавца до даты, которую назначил продавец.
Дата, кстати, уже гуляет: карточка студии стоит на пятом ноября, а половина каталогов записала релиз на шестое — так выглядит разница между объявлением и появлением в чужой таблице. Ничего злого, просто ещё один повод сверять шапку, а не пересказ.
Единственная цифра в релизе, за которой стоит счёт, а не балл: в примере с авторесёрчем Inkling 2 Small сама обучила LoRA для Qwen3.5-4B, потратила на это четыре с половиной часа и 426 долларов на Tinker, и качество прогноза больше чем удвоилось. Расходы на дообучение впервые стоят рядом с результатом как строка в счёте. Для того, кто выбирает платформу, это важнее тридцати одного балла.
Сто задач, где правильный ответ — «данных мало»
OpenAI выложила BioBasicsBench — сто задач по рутине мокрой лаборатории, собранных вместе с биотех-компанией Ligo: гели, чашки с колониями, микроскопия, выгрузки приборов, видео работы на столе. Смысл не в том, чтобы прочитать статью, а в том, чтобы прочитать сырой результат эксперимента, заметить ошибку в контроле и, если данных не хватает, сказать это вслух.
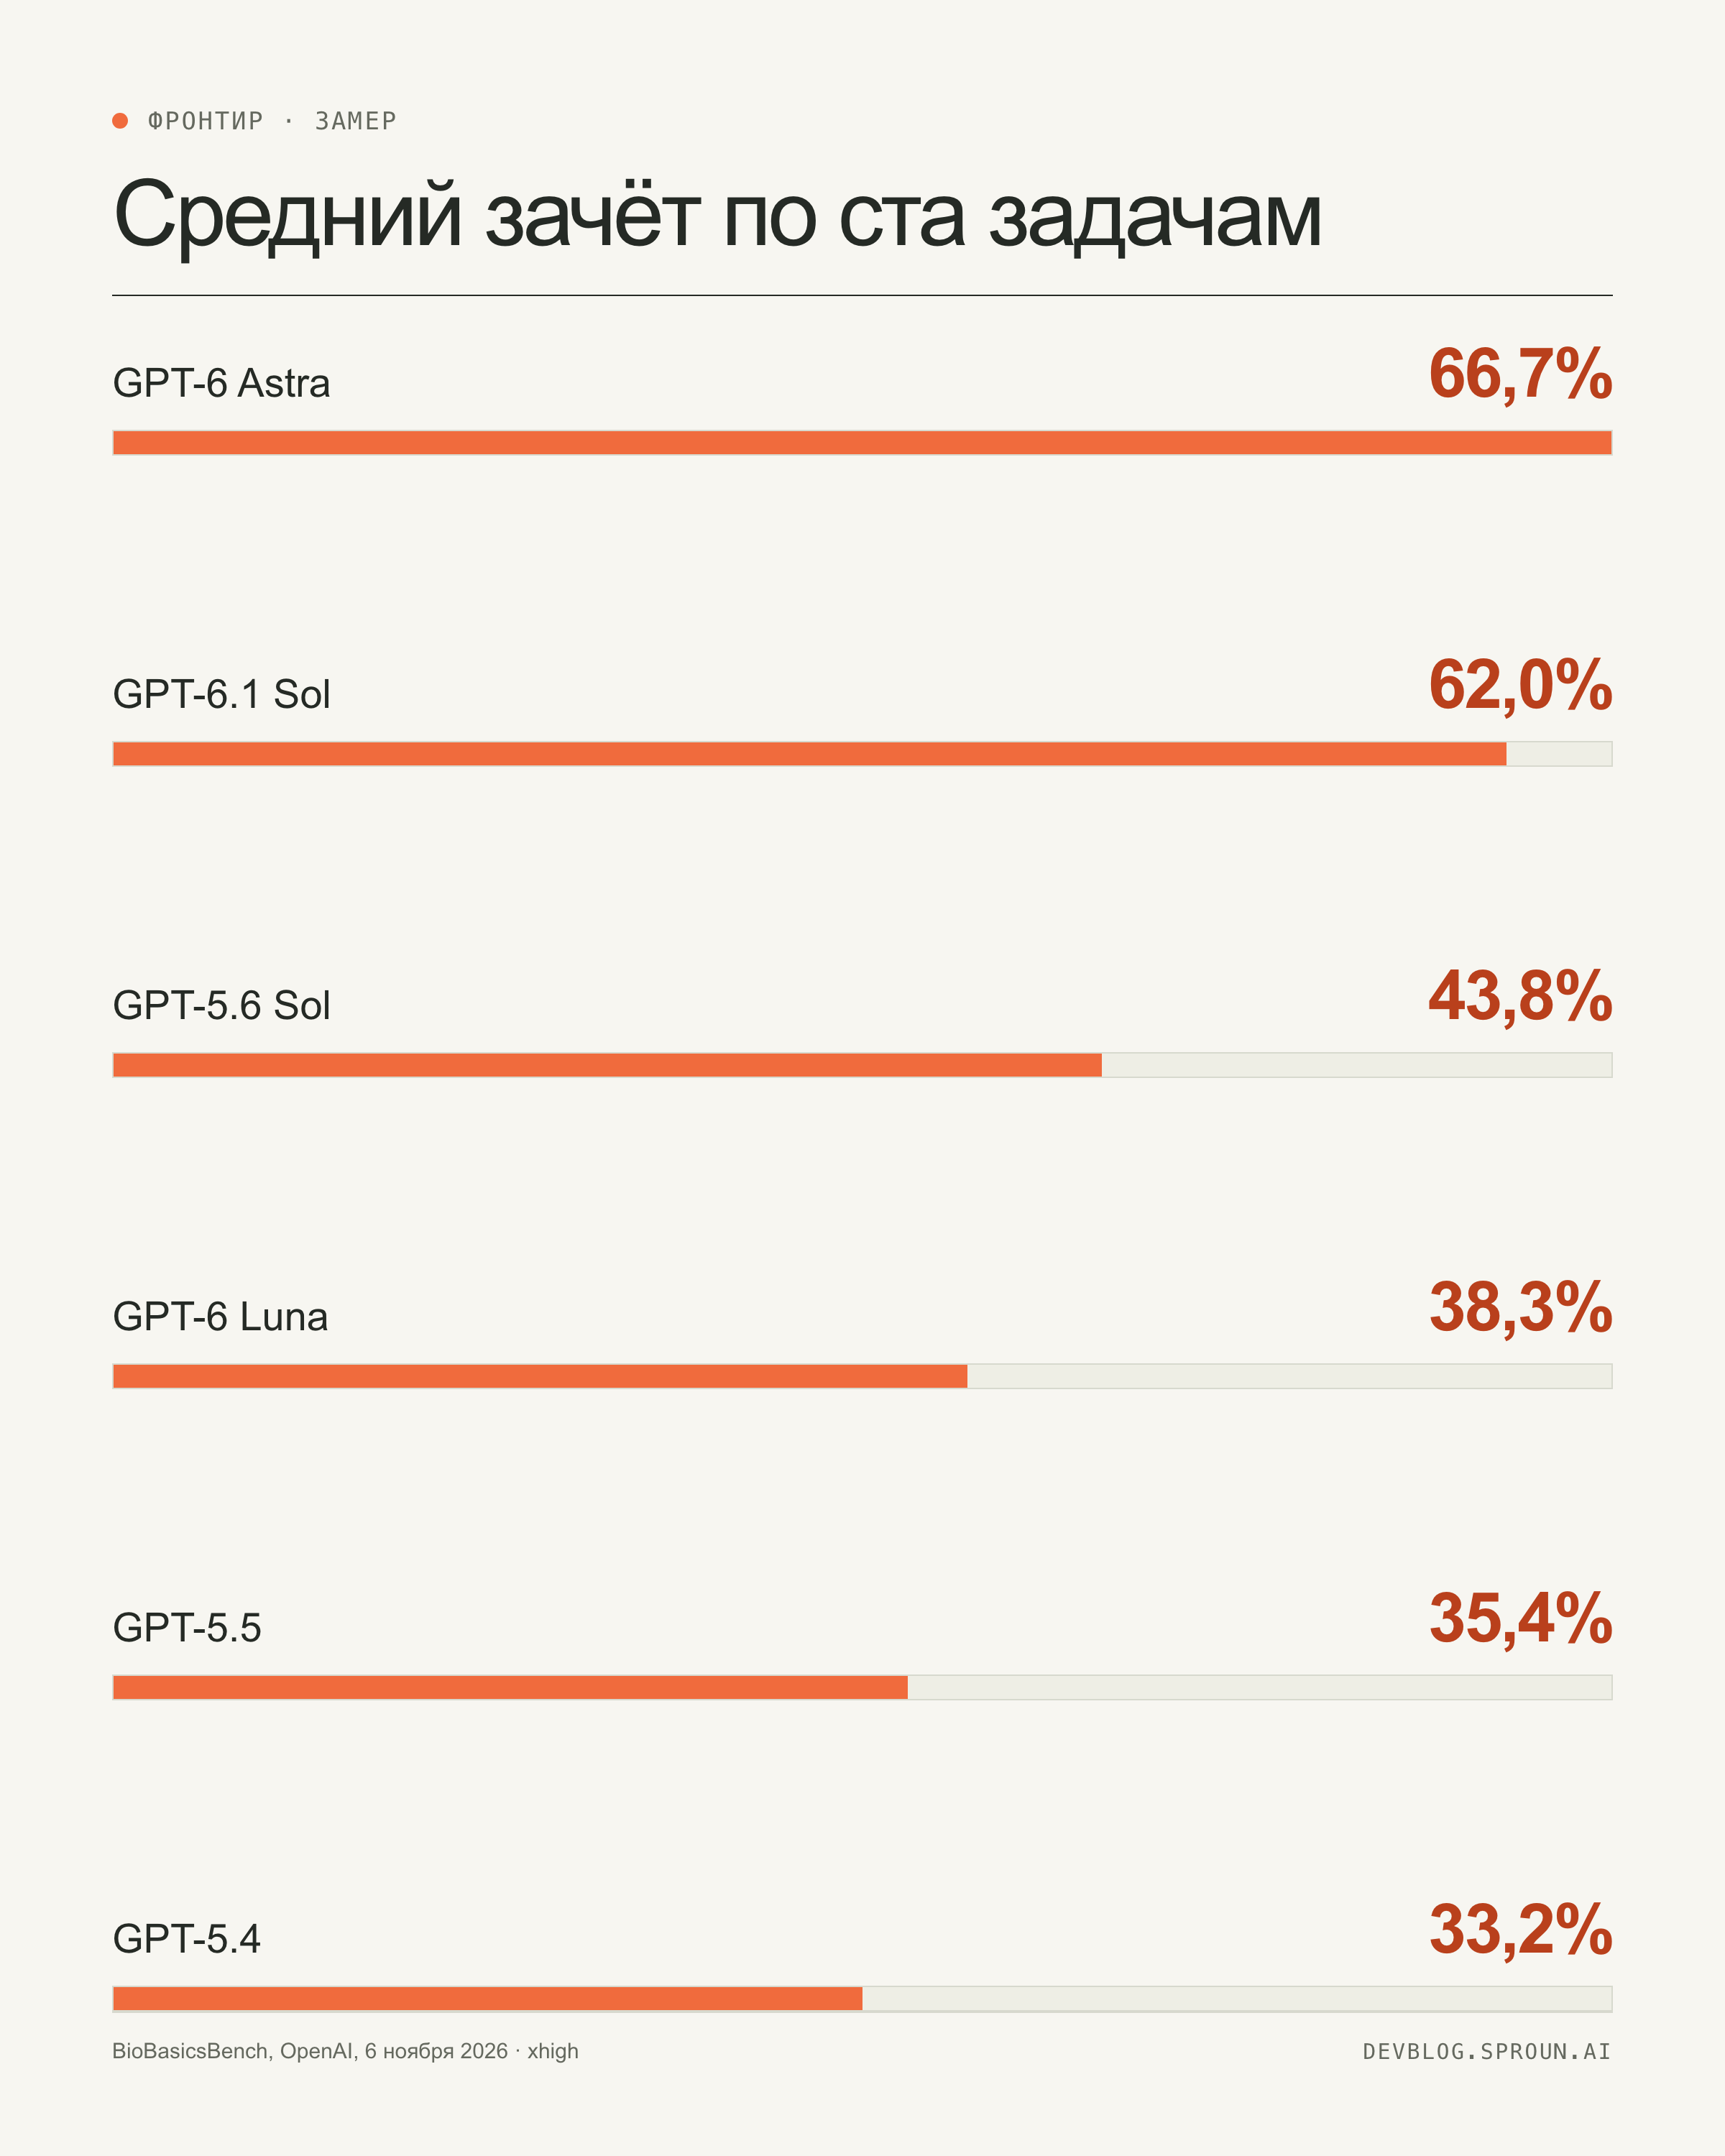
В шапке: 66,7% среднего зачёта у GPT-6 Astra при максимальном усилии против 43,8% у GPT-5.6 Sol. Семь моделей, 37 настроек, по пять попыток на каждую из ста задач — 18 500 результатов. Число честное и одновременно обманчивое: это доля рубрик, по которым ответ зачли, а не доля правильных выводов.
Самое ценное на странице — раздел, где модель ошибается. Astra замечает, что чашка отрицательного контроля подписана другим антибиотиком, и отказывается считать её контролем; предыдущая модель просто увидела «колоний нет» и сделала вывод. Тут же, на другом примере, Astra подставляет знакомое допущение вместо сравнения с контролем и называет не те дорожки. Бенчмарк, который печатает свои провалы, — проверка, которой можно верить больше, чем строке в лидерборде.
Знак, который снимается настройкой
Третья история короче. С третьего ноября текст Claude Sonnet 4.6 у Anthropic несёт невидимый водяной знак: рисунок в выборе слов, который едет вместе с текстом при копировании и может пережить правку. Своей рукой его не увидеть и не проверить — это инструмент держателя ключа, а не читателя, и в примечаниях к той же странице перечислено, когда знака может не быть вовсе.
Одна из причин — в одном слове: если в запросе выставить температуру, top_p или top_k не по умолчанию, знак может не появиться. То есть проверка, задуманная как гарантия, отключается одной строкой в запросе, и отключает её не злоумышленник, а тот, кто просто подкрутил выбор слов.
Для блога это ровно та же проблема, что и с любым «мы промаркировали»: знак отвечает на вопрос, участвовала ли эта модель, а не на вопрос, кто написал этот абзац. Между этими вопросами лежит вся работа редактора — и её знак не видит.
Итог за двое суток: три проверки, и у каждой в описании своя щель — неделя ожидания, рубрика вместо вывода, настройка вместо знака. Ни одна не даёт читателю права проверить самому; все три дают право спросить, кто поставил проверку и чего она не ловит.
У Inkling 2 Small весов пока нет. У BioBasicsBench лучший результат — 66,7%. У водяного знака — примечание сбоку. Три щели, и все три написаны в самих документах: в обещании, в разделе «где модели ошибаются», в сноске о настройках.